EXP-03 · deep learning
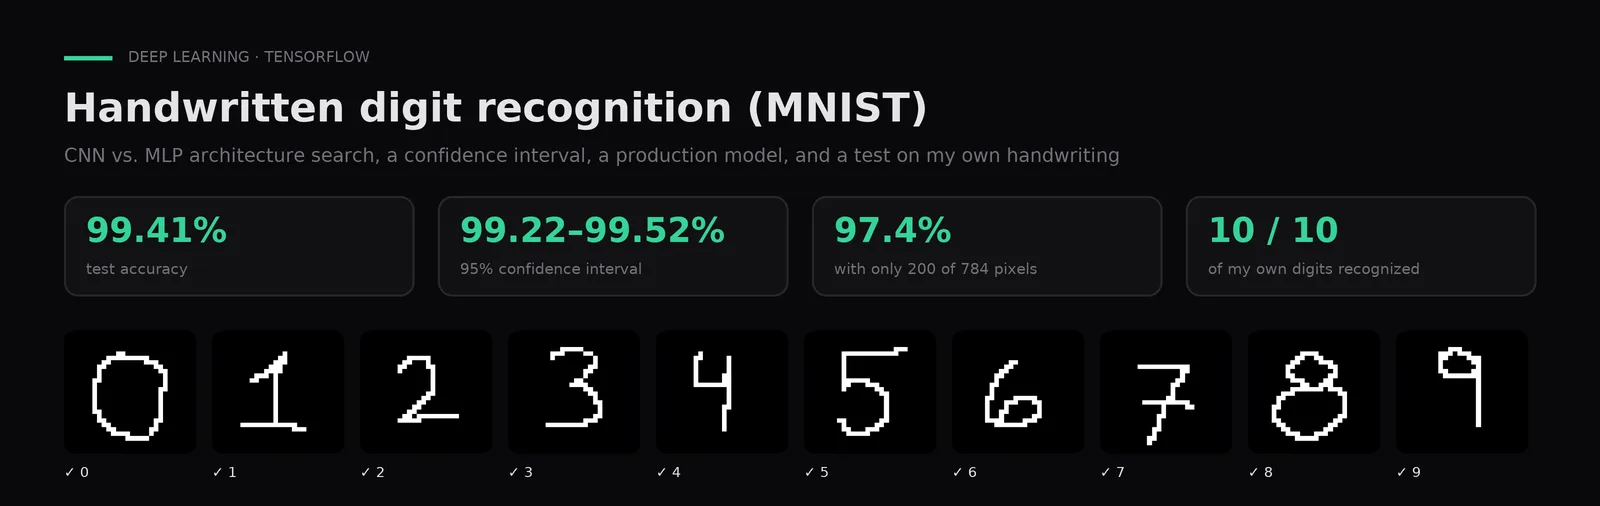
¿Entiende mi letra?
Búsqueda de arquitectura entre MLP y CNN, intervalo de confianza para la accuracy, modelo de producción y prueba con dígitos escritos a mano por mí.
Pregunta
¿Un modelo con 99% en MNIST sigue funcionando con dígitos que dibujé yo, fuera del dataset?
Problema
Clasificar dígitos del 0 al 9 escritos a mano y comprobar que el modelo generaliza fuera del dataset.
Datos
MNIST: 70.000 imágenes de 28×28 en escala de grises de dígitos del 0 al 9 (60.000 de entrenamiento y 10.000 de test), cargadas desde Keras. Además, 10 dígitos dibujados por mí para probar el modelo fuera del dataset.
Método
EDA, splits estratificados, grid de 32 configuraciones de MLP y CNN sin Keras Tuner, IC 95% de Wilson, selección de 200 variables por información mutua, re-entrenamiento con train+val y preprocesamiento con OpenCV para imágenes propias.
Resultado
99,41% de accuracy en test (IC 95%, 99,22–99,52% en el modelo de producción) y los 10 dígitos que escribí a mano reconocidos correctamente.
Lo que aprendí
Con solo 200 de los 784 píxeles mantiene 97,4%: la mayoría de los píxeles es ruido.
Stack
- Python
- TensorFlow
- Keras
- scikit-learn
- OpenCV
Contexto
Materia: Aprendizaje Automático III · 2025