2024
Titanic, ingeniería de variables y Random Forest
Clasificación de supervivencia con ingeniería de variables (títulos, familia, cubierta, frecuencia de ticket) y Random Forest ajustado con GridSearch.
Problema
Predecir qué pasajeros sobrevivieron a partir de sus datos de viaje.
Datos
Titanic de Kaggle (set de entrenamiento): 891 pasajeros con clase, sexo, edad, familia, ticket, tarifa, cabina y puerto. Se incluye en `data/titanic.csv`.
Método
Imputación por grupos, extracción de títulos y apellidos, variables de familia y cubierta, información mutua y GridSearch con 216 combinaciones y 3 folds.
Resultado
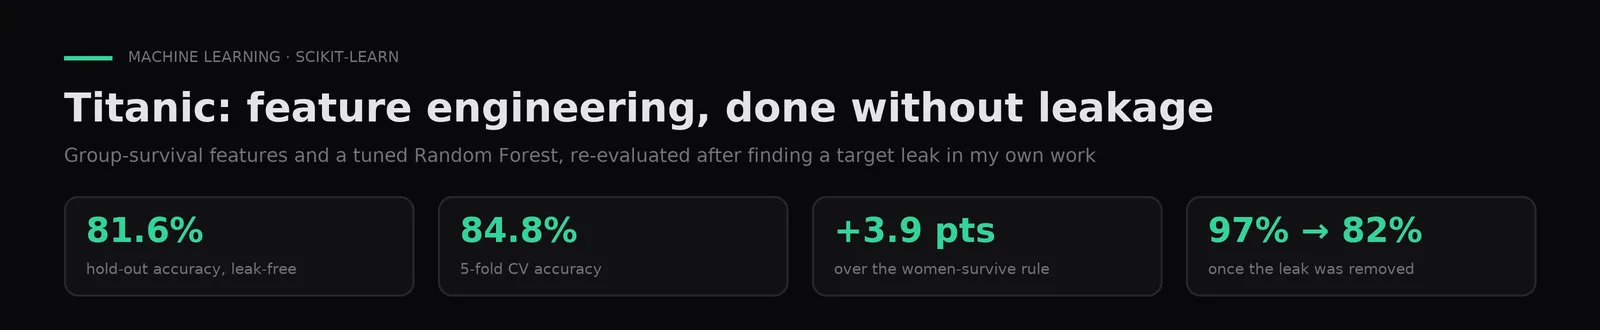
Sin fuga de datos, el Random Forest logra 81,6% en el hold-out (84,8% en validación cruzada), 3,9 puntos por encima de la regla "sobreviven las mujeres". El 98,9% del notebook original venía de calcular tasas de supervivencia por familia y ticket con todo el dataset.
Stack
- Python
- scikit-learn
- pandas
- Seaborn
Contexto
Materia: Aprendizaje Automático I · 2024